
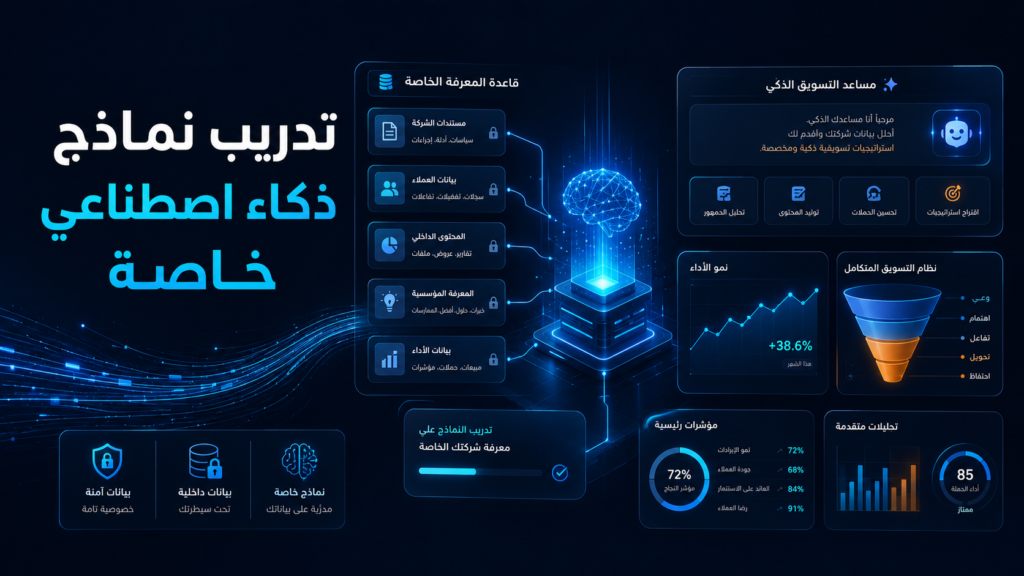
تدريب نماذج ذكاء اصطناعي خاصة: كيف تغذي الـ Custom GPT ببيانات شركتك الداخلية لتدريب مسوق ذكي يفهم عملاءك بدقة؟
لم يعد استخدام أدوات الذكاء الاصطناعي العامة كافياً للشركات التي تريد نمواً تسويقياً قابلاً للقياس. فالأداة العامة قد تكتب إعلاناً جيداً، أو تقترح فكرة محتوى، أو تلخص تقريراً، لكنها لا تفهم بالضرورة طبيعة عملائك، اعتراضاتهم، دورة الشراء، صوت علامتك التجارية، أو الفروق الدقيقة بين شرائح السوق التي تستهدفها.
هنا تظهر قيمة تدريب نماذج ذكاء اصطناعي خاصة عبر بناء Custom AI Knowledge Base متصلة ببيانات شركتك الداخلية. الفكرة ليست أن “تعلّم” النموذج من الصفر بالمعنى التقني العميق، بل أن تزوّده ببنية معرفية منظمة تجعله يستجيب كمسوق ذكي يعرف سياق الشركة، لا كأداة عامة تعتمد على توقعات واسعة.
في بيئة B2B، الفارق بين محتوى عام ومحتوى مؤثر قد يكون في جملة واحدة: هل يفهم النظام من هو العميل المثالي؟ هل يعرف أسباب خسارة الصفقات؟ هل يميز بين Lead عالي الجودة وآخر غير مؤهل؟ هل يستطيع اقتراح رسالة تسويقية مرتبطة فعلاً بمراحل الـMarketing Funnel؟
وفقاً لتقرير McKinsey لعام 2025، تستخدم 78% من المؤسسات الذكاء الاصطناعي في وظيفة عمل واحدة على الأقل، وكانت وظائف التسويق والمبيعات من أكثر المجالات استخداماً له؛ لكن التقرير يوضح أيضاً أن معظم المؤسسات لم تحقق بعد أثراً ملموساً على مستوى الربحية المؤسسية من استخدام Gen AI، ما يعكس أن القيمة لا تأتي من تبني الأداة فقط، بل من إعادة تصميم workflows، الحوكمة، ومؤشرات القياس.
هذا بالضبط ما يجعل بناء قاعدة معرفة داخلية مخصصة خطوة استراتيجية، لا مجرد تجربة تقنية.
لماذا لم يعد استخدام أدوات AI العامة كافياً في التسويق؟
الأدوات العامة تعمل على احتمالات لغوية واسعة. هي تفهم اللغة، لكنها لا تفهم شركتك تلقائياً. قد تكتب محتوى جذاباً من حيث الأسلوب، لكنه لا يعكس:
- موقعك الحقيقي في السوق.
- الفئة الأكثر ربحية من العملاء.
- نبرة العلامة التجارية.
- الفروق بين منتجاتك وخدماتك.
- أسباب الاعتراض المتكررة لدى العملاء.
- بيانات الأداء الفعلية من الحملات.
- الدروس المستخلصة من المبيعات وخدمة العملاء.
في التسويق الحديث، الذكاء لا يعني إنتاج محتوى أسرع فقط. الذكاء يعني ربط المحتوى بالاستراتيجية، وربط الاستراتيجية بالبيانات، وربط البيانات بقرارات نمو قابلة للتنفيذ.
لذلك، عندما تعتمد الشركة على نموذج عام فقط، فهي غالباً تحصل على مخرجات تبدو جيدة، لكنها تظل بعيدة عن جوهر القرار التجاري. أما عند بناء نظام معرفي مخصص، يصبح الـCustom GPT قادراً على العمل وفق سياق الشركة، وليس وفق قوالب تسويقية عامة.
ولهذا تحتاج الشركات التي تتعامل مع AI بجدية إلى بناء نظام محتوى وسيو مدعوم بالذكاء الاصطناعي بدل الاكتفاء باستخدام أدوات منفصلة بلا بنية معرفية واضحة.
ما المقصود بـ Custom AI Knowledge Base؟
Custom AI Knowledge Base هي قاعدة معرفة منظمة تحتوي على وثائق، بيانات، إرشادات، أمثلة، وقواعد تشغيلية تساعد نموذج الذكاء الاصطناعي على فهم شركتك وسياقها التجاري.
في حالة Custom GPT، تتيح خاصية Knowledge للنموذج استخدام ملفات ترفعها له كمراجع أثناء المحادثات، مثل الوثائق، الأدلة، الكتيبات، والمحتوى الداخلي. وتوضح OpenAI أن التعليمات Instructions تحدد سلوك الـGPT، بينما ملفات Knowledge تمنحه المادة المرجعية التي يعتمد عليها عند الإجابة.
هذا التفريق مهم جداً. فليست كل البيانات مناسبة لوضعها في خانة التعليمات، وليست كل التعليمات مناسبة كملفات معرفة.
يمكن تبسيط الفكرة كالآتي:
| العنصر | وظيفته داخل النظام |
|---|---|
| Instructions | تحدد شخصية النموذج، طريقة العمل، القيود، الخطوات، ونبرة الرد |
| Knowledge Files | تمنح النموذج مصادر داخلية يرجع إليها |
| Conversation Starters | توجه المستخدمين إلى حالات استخدام واضحة |
| Testing & Feedback | يكشف فجوات الدقة والسياق |
| Governance | يحدد ما يجوز استخدامه وما يجب حمايته |
النتيجة ليست مجرد Chatbot. النتيجة هي مساعد تسويقي داخلي يمكنه التفكير ضمن حدود بيانات الشركة.
كيف يتحول الـCustom GPT إلى مسوق ذكي يفهم عملاءك؟
لكي يتحول Custom GPT إلى مسوق ذكي، يجب أن يتم تغذيته بمعلومات تتجاوز وصف المنتج. المسوق الذكي لا يعرف “ماذا تبيع” فقط، بل يعرف لمن تبيع، ولماذا يشتري العميل، وما الذي يمنعه من اتخاذ القرار.
النظام الجيد يجب أن يفهم أربع طبقات:
1. طبقة السوق
تشمل حجم السوق، المنافسين، الاتجاهات، الفئات المستهدفة، الفروق الجغرافية، سلوك الشراء، ومستوى نضج العملاء.
هذه الطبقة مهمة خصوصاً للشركات التي تعمل في أسواق الخليج أو الأسواق متعددة اللغات، لأن الرسالة التي تنجح في سوق قد تفشل في آخر.
عند بناء استراتيجية دخول سوق جديد، يمكن ربط هذا النظام مع بناء استراتيجية تسويق دولي قابلة للتنفيذ حتى لا يعمل الذكاء الاصطناعي بمعزل عن الخطة التجارية.
2. طبقة العميل
هنا يجب إدخال ملفات مثل:
- Ideal Customer Profile.
- Buyer Personas.
- أسئلة العملاء المتكررة.
- اعتراضات المبيعات.
- أسباب خسارة الصفقات.
- أسباب اختيار العملاء الحاليين للشركة.
- رسائل البريد أو المحادثات المتكررة.
- تقييمات العملاء وشهاداتهم.
هذه البيانات تجعل النموذج أقرب إلى الواقع التجاري، لأنه لا يكتب بناءً على افتراضات نظرية، بل بناءً على لغة العملاء الفعلية.
3. طبقة العرض التجاري
تشمل المنتجات، الخدمات، الباقات، الأسعار إن أمكن، مزايا كل عرض، الحالات المناسبة وغير المناسبة، نقاط التميز، وقيود التسليم.
هذه الطبقة تمنع النموذج من اقتراح وعود لا تستطيع الشركة تنفيذها، أو صياغة رسائل تسويقية خارج القدرة التشغيلية.
4. طبقة الأداء
تشمل بيانات الحملات، نسب التحويل، تكلفة اكتساب العملاء Customer Acquisition Cost، جودة العملاء المحتملين Lead Quality، مصادر الزيارات، وأداء المحتوى.
بدون هذه الطبقة، سيظل النموذج جيداً في الكتابة، لكنه ضعيف في اتخاذ القرار.
لذلك، تحتاج الشركات التي تستخدم الذكاء الاصطناعي في التسويق إلى ربط النظام المعرفي مع بناء Tracking Infrastructure دقيقة وآمنة لشركتك حتى تصبح توصياته مبنية على إشارات أداء حقيقية.
ما البيانات التي يجب تغذية الـCustom GPT بها؟
ليست كل بيانات الشركة مناسبة للنموذج. الخطأ الشائع هو رفع كمية كبيرة من الملفات العشوائية ثم توقع نتائج دقيقة. الجودة هنا أهم من الحجم.
القاعدة التنفيذية هي:
كل ملف يدخل إلى قاعدة المعرفة يجب أن يخدم قراراً تسويقياً أو تشغيلياً واضحاً.
أهم أنواع البيانات التي يجب تجهيزها
1. وثائق العلامة التجارية
تشمل:
- Brand Guidelines.
- Tone of Voice.
- الرسائل الرئيسية.
- الكلمات المسموحة والممنوعة.
- تموضع الشركة.
- نقاط التمييز.
- طريقة مخاطبة كل شريحة.
هذه الوثائق تمنع تضارب النبرة، خصوصاً عندما تنتج فرق متعددة محتوى عبر قنوات مختلفة.
2. بيانات العملاء والمبيعات
تشمل:
- ملخصات مكالمات المبيعات.
- أسباب الاعتراض.
- أسباب خسارة العملاء.
- أفضل الأسئلة التي تؤدي إلى تأهيل العميل.
- رسائل العملاء في WhatsApp أو البريد أو CRM.
- الفروق بين Lead مؤهل وغير مؤهل.
هذه البيانات تساعد النموذج على تحسين الرسائل، صفحات الهبوط، سلاسل البريد، والإعلانات.
وإذا كانت الشركة تمتلك دورة مبيعات معقدة، فإن ربط النظام المعرفي مع حجز استشارة CRM Sales Automation يساعد في تحويل المعرفة إلى workflows داخلية قابلة للتطبيق.
3. محتوى الشركة الحالي
يشمل:
- صفحات الموقع.
- المقالات.
- دراسات الحالة.
- العروض التقديمية.
- كتيبات الخدمات.
- منشورات LinkedIn.
- النصوص الإعلانية السابقة.
- Scripts المبيعات وخدمة العملاء.
هذه المواد تساعد النموذج على فهم تاريخ العلامة التجارية وما تم استخدامه سابقاً، لكنها تحتاج إلى تنظيف وتصنيف قبل رفعها.
4. بيانات الحملات والأداء
تشمل:
- تقارير Meta Ads وGoogle Ads.
- أفضل الإعلانات أداءً.
- Landing Pages عالية التحويل.
- حملات ضعيفة الأداء.
- مؤشرات ROAS وCAC.
- نتائج A/B Testing.
- تحليلات Attribution.
إذا كان الهدف من النظام تحسين الأداء وليس إنتاج محتوى فقط، فيجب ربط قاعدة المعرفة مع تحليل أداء الحملات وتقليل تكلفة اكتساب العملاء.
5. بيانات تجربة المستخدم والتحويل
تشمل:
- خرائط رحلة العميل.
- تسجيلات الجلسات.
- Heatmaps.
- نتائج الاستبيانات.
- أسئلة ما قبل الشراء.
- نقاط التسرب داخل صفحات الهبوط.
هذه البيانات تجعل النموذج أكثر قدرة على اقتراح تحسينات في Conversion Rate Optimization، وليس مجرد عناوين تسويقية جذابة.
وهنا يصبح من المنطقي دعم النظام عبر حجز تدقيق CRO لتحسين معدل التحويل عند وجود زيارات جيدة لكن التحويلات ضعيفة.
خطوات بناء Custom AI Knowledge Base فعّالة للتسويق
بناء قاعدة معرفة للذكاء الاصطناعي لا يبدأ برفع الملفات. يبدأ بتحديد وظيفة النظام.
هل تريد مسوقاً ذكياً لكتابة المحتوى؟
هل تريد مساعداً لتحليل الحملات؟
هل تريد AI Sales Agent يؤهل العملاء؟
هل تريد نظاماً يدعم فريق التسويق في التخطيط والتنفيذ؟
أم تريد قاعدة معرفية شاملة تعمل كطبقة ذكاء داخل الشركة؟
كل هدف يحتاج بنية مختلفة.
الخطوة الأولى: تحديد حالات الاستخدام
قبل أي إعداد تقني، يجب تعريف حالات الاستخدام بدقة. على سبيل المثال:
| حالة الاستخدام | المخرج المطلوب |
|---|---|
| كتابة مقالات SEO | Outline، مقالة، FAQ، Meta Data |
| تحليل الحملات | تفسير الأداء، فرضيات تحسين، توصيات |
| دعم فريق المبيعات | إجابات على الاعتراضات، Scripts، تأهيل Lead |
| إنتاج محتوى LinkedIn | أفكار، منشورات، زوايا قيادية |
| تحليل العملاء | Personas، Pain Points، Segmentation |
كلما كانت حالة الاستخدام واضحة، أصبح تدريب النموذج أكثر دقة.
الخطوة الثانية: تنظيف البيانات
النموذج لا يحتاج إلى كل شيء. يحتاج إلى نسخة منظمة من المعرفة.
يجب إزالة:
- الملفات المكررة.
- العروض القديمة.
- الأسعار غير المعتمدة.
- الرسائل المتضاربة.
- المحتوى منخفض الجودة.
- البيانات الحساسة غير الضرورية.
- الملفات التي تحتوي على معلومات غير محدثة.
هذه المرحلة هي ما يميز نظاماً احترافياً عن تجربة عشوائية.
الخطوة الثالثة: تصنيف المعرفة
يجب تقسيم الملفات إلى مجموعات واضحة، مثل:
- Brand.
- Products.
- Customers.
- Sales.
- Marketing.
- SEO.
- Ads.
- CRO.
- Analytics.
- Operations.
التصنيف يساعد في تحسين جودة الاسترجاع Retrieval ويقلل احتمالية الخلط بين مصادر مختلفة.
الخطوة الرابعة: كتابة Instructions قوية
ملفات المعرفة وحدها لا تكفي. يجب أن يعرف النموذج كيف يستخدمها.
التعليمات يجب أن تحدد:
- دور النموذج.
- الجمهور المستهدف.
- نبرة الرد.
- طريقة الاستشهاد بالمصادر الداخلية.
- ما يجب فعله عند نقص المعلومات.
- ما لا يجوز افتراضه.
- طريقة ترتيب المخرجات.
- الأولويات التجارية.
- معايير الجودة.
OpenAI توصي باستخدام تعليمات واضحة ومقسمة، مع أمثلة وتعريفات عند الحاجة، واختبار الـGPT بعد رفع المعرفة للتأكد من أنه يستخدم الملفات كما هو متوقع.
الخطوة الخامسة: اختبار النموذج بسيناريوهات واقعية
لا تختبر النظام بسؤال عام مثل: “اكتب لي منشوراً”.
اختبره بسيناريوهات قريبة من الواقع:
- اكتب إعلاناً لخدمة محددة يستهدف CFO في شركة متوسطة.
- حلل سبب ضعف التحويل في صفحة هبوط.
- اقترح ردوداً على اعتراضات عملاء SaaS.
- حوّل مكالمة مبيعات إلى Insights للمحتوى.
- اقترح خطة محتوى بناءً على فجوات SEO.
- صنّف Leads حسب احتمالية الشراء.
الاختبار يجب أن يقيس الدقة، الاتساق، الالتزام بالنبرة، وفهم السياق.
الخطوة السادسة: بناء دورة Feedback مستمرة
قاعدة المعرفة ليست مشروعاً ينتهي بعد الإطلاق. هي نظام حي.
يجب تحديثها عند:
- إطلاق خدمة جديدة.
- تغيير التسعير.
- دخول سوق جديد.
- ظهور اعتراضات متكررة.
- تغير أداء الحملات.
- تحديث ICP.
- اكتشاف فجوة في الردود.
- إضافة Case Studies جديدة.
هنا يصبح حجز AI Content Engine مخصص لشركتك خطوة عملية لبناء نظام معرفي يتطور مع الشركة، لا مجرد GPT ثابت يتقادم بعد أسابيع.
أين تظهر القيمة التجارية لتدريب نماذج ذكاء اصطناعي خاصة؟
القيمة لا تظهر فقط في سرعة كتابة المحتوى. القيمة الحقيقية تظهر عندما يصبح الذكاء الاصطناعي جزءاً من Revenue System.
1. تحسين جودة المحتوى
النموذج المخصص ينتج محتوى أكثر ارتباطاً بالسوق والعميل. بدلاً من مقالات عامة، يمكنه بناء محتوى يعكس:
- نية البحث.
- مراحل الوعي.
- أسئلة العملاء الفعلية.
- نقاط الألم.
- اللغة التجارية المناسبة.
- الفروق بين قطاعات العملاء.
وعند دمج ذلك مع بناء استراتيجية SEO حديثة للنمو العضوي، تصبح قاعدة المعرفة محركاً لإنتاج محتوى قابل للترتيب والاقتباس في AI Overviews.
2. تقليل الفجوة بين التسويق والمبيعات
في كثير من الشركات، يعمل التسويق برسائل تختلف عن لغة فريق المبيعات. قاعدة المعرفة المخصصة توحّد المصدر.
عندما يتم تغذية النظام بمكالمات المبيعات، اعتراضات العملاء، وصفقات رابحة وخاسرة، يبدأ التسويق في إنتاج رسائل أقرب للواقع.
هذا يقلل الهدر في الحملات ويحسّن جودة العملاء المحتملين.
3. تسريع إنتاج الأصول التسويقية
يمكن للنظام إنتاج:
- Landing Page briefs.
- Email sequences.
- Ads angles.
- Sales scripts.
- LinkedIn posts.
- Webinar outlines.
- FAQ pages.
- Case study drafts.
- SEO content briefs.
لكن السرعة هنا ليست الهدف الوحيد. الهدف هو إنتاج أسرع مع اتساق أعلى وجودة أقرب للقرار التجاري.
4. دعم فرق المبيعات وخدمة العملاء
عندما يمتلك النظام معرفة دقيقة بالمنتجات، الاعتراضات، والأسئلة المتكررة، يمكن استخدامه لتجهيز ردود مبيعات أكثر ذكاءً.
ومع تطور النضج، يمكن الانتقال إلى حجز AI Sales Agent System لتأهيل العملاء أو بناء مساعدين داخليين يدعمون فرق المبيعات في التأهيل والردود والمتابعة.
5. تحسين اتخاذ القرار التسويقي
إذا تم ربط النظام بتقارير الأداء، يستطيع مساعدة الفريق في طرح فرضيات أفضل:
- لماذا ارتفع CAC؟
- ما الفرق بين حملة تولّد Leads كثيرة وحملة تولّد Leads مؤهلة؟
- ما الرسائل التي تتكرر في الصفقات الرابحة؟
- ما صفحات الموقع التي تحتاج تحسيناً؟
- ما المحتوى الذي يخدم مراحل القرار المتأخرة؟
هذه القدرة تجعل الذكاء الاصطناعي أقرب إلى Growth Analyst، لا مجرد كاتب محتوى.
أخطاء شائعة عند تغذية Custom GPT ببيانات الشركة
الخطأ الأول: رفع ملفات كثيرة بدون تنظيم
كثرة الملفات لا تعني جودة أعلى. أحياناً تؤدي إلى تضارب في الإجابات، خصوصاً إذا كانت الملفات قديمة أو متكررة أو تحمل رسائل مختلفة.
الأفضل هو بناء مكتبة معرفة مختصرة، مصنفة، ومحدثة.
الخطأ الثاني: خلط التعليمات بالمراجع
التعليمات تحدد السلوك، والمراجع تمنح المعرفة.
عندما تضع كل شيء في مكان واحد، يصبح النظام أقل انضباطاً.
يجب فصل:
- قواعد النبرة والسلوك.
- مصادر المعرفة.
- أمثلة المخرجات.
- القيود القانونية أو التجارية.
- خطوات العمل.
الخطأ الثالث: إدخال بيانات حساسة بلا حوكمة
ليس كل ما تعرفه الشركة يجب أن يدخل إلى النظام.
يجب تقييم:
- بيانات العملاء الشخصية.
- العقود.
- الأسعار الخاصة.
- الأسرار التجارية.
- البيانات المالية.
- معلومات الموظفين.
- الوثائق القانونية.
الشركة الذكية لا تبني AI Knowledge Base فقط، بل تبني معها إطار حوكمة واضحاً. وهذا يتماشى مع قواعد إعداد محتوى Mahira وروابطها الداخلية المعتمدة لاختيار الرابط المناسب حسب الهدف والكاتيجوري.
الخطأ الرابع: عدم اختبار النموذج قبل استخدامه
أي نموذج غير مختبر قد ينتج توصيات تبدو منطقية لكنها غير دقيقة. يجب اختباره داخلياً قبل تعميمه على الفرق.
الاختبار يجب أن يشمل:
- أسئلة سهلة.
- أسئلة معقدة.
- حالات نقص معلومات.
- تعارض بين ملفات.
- طلبات خارج نطاقه.
- سيناريوهات ضغط تشبه الاستخدام الحقيقي.
الخطأ الخامس: التعامل معه كبديل للفريق
النموذج المخصص لا يلغي دور المسوقين. هو يرفع مستوى الفريق عندما تكون البيانات منظمة والعمليات واضحة.
أفضل استخدام له هو Human-in-the-loop:
النظام يقترح، يحلل، يصيغ، ويختصر؛ والفريق يراجع، يقرر، ويقود الاتجاه الاستراتيجي.
كيف تبني Mahira نظاماً معرفياً ذكياً للشركات؟
في Mahira، لا يتم التعامل مع Custom GPT كأداة منفصلة، بل كجزء من منظومة نمو أوسع تشمل المحتوى، SEO، الحملات، التحليلات، الأتمتة، وRevenue Operations.
الهدف ليس بناء مساعد يرد على الأسئلة فقط. الهدف هو بناء طبقة ذكاء داخلية تساعد الشركة على:
- تحويل المعرفة المتفرقة إلى نظام قابل للاستخدام.
- توحيد الرسائل بين التسويق والمبيعات.
- تحسين جودة المحتوى والمخرجات.
- تسريع تنفيذ الحملات.
- دعم فرق التسويق بقرارات مبنية على البيانات.
- تجهيز الشركة لاستخدام AI Agents لاحقاً.
قد يبدأ المشروع بـCustom AI Knowledge Base للمحتوى، ثم يتوسع لاحقاً إلى بناء وكلاء ذكاء اصطناعي للتسويق داخل شركتك أو حجز Operations Automation System عند الحاجة إلى ربط المعرفة بالعمليات اليومية.
وفي الشركات التي تريد بناء نظام نمو شامل، يمكن أن يصبح هذا النظام جزءاً من تطوير منظومة نمو تربط التسويق بالمبيعات والتحليلات.
متى تحتاج شركتك إلى Custom AI Knowledge Base؟
تحتاج شركتك إلى قاعدة معرفة مخصصة إذا ظهرت واحدة أو أكثر من هذه العلامات:
- الفريق يستخدم ChatGPT لكن النتائج متفاوتة.
- كل شخص يكتب بنبرة مختلفة.
- المحتوى لا يعكس خبرة الشركة الحقيقية.
- فريق التسويق لا يستفيد من Insights المبيعات.
- هناك تكرار كبير في الأسئلة الداخلية.
- الحملات تنتج Leads كثيرة لكن جودتها ضعيفة.
- الشركة تمتلك ملفات كثيرة ولا توجد طريقة ذكية لاستخدامها.
- الإدارة تريد تبني AI لكن تخشى الفوضى أو عدم الدقة.
- لديك معرفة داخلية قوية لكنها غير موثقة أو غير قابلة للتوسع.
في هذه الحالة، المشكلة ليست في الأداة. المشكلة في غياب البنية المعرفية.
وهنا يصبح بناء نظام محتوى وسيو مدعوم بالذكاء الاصطناعي خياراً عملياً لتحويل المعرفة الداخلية إلى أصل تسويقي قابل للتشغيل.
كيف تقيس نجاح تدريب نماذج ذكاء اصطناعي خاصة؟
نجاح النظام لا يقاس بعدد الملفات المرفوعة أو عدد الردود المنتجة. يجب قياسه بمؤشرات تشغيلية وتجارية.
مؤشرات الجودة
- دقة الإجابات.
- الالتزام بنبرة العلامة.
- انخفاض الأخطاء.
- جودة الاستشهاد بالمصادر الداخلية.
- قدرة النموذج على قول “لا أعرف” عند غياب البيانات.
مؤشرات الإنتاجية
- تقليل وقت إنتاج Briefs.
- تقليل وقت كتابة المسودات.
- تسريع تجهيز الحملات.
- تقليل تكرار الأسئلة بين الفرق.
- تحسين سرعة البحث في المعرفة الداخلية.
مؤشرات النمو
- تحسن Conversion Rate.
- انخفاض CAC.
- ارتفاع Lead Quality.
- زيادة إنتاج المحتوى المؤهل للترتيب.
- تحسين أداء صفحات الهبوط.
- تقليل الفجوة بين التسويق والمبيعات.
كلما ارتبط النظام بمؤشرات قياس واضحة، أصبح استثماراً في النمو، لا مجرد تجربة AI.
الخاتمة: تدريب نماذج ذكاء اصطناعي خاصة ليس مشروع تقنية فقط
تدريب نماذج ذكاء اصطناعي خاصة لا يعني شراء أداة جديدة أو رفع ملفات إلى Custom GPT ثم انتظار نتائج استثنائية. المعنى الحقيقي هو بناء نظام معرفي منظم يجعل الذكاء الاصطناعي يفهم سياق شركتك، عملاءك، خدماتك، بياناتك، ورسائلك التجارية.
الشركات التي ستربح من AI في التسويق ليست بالضرورة التي تستخدم أكبر عدد من الأدوات، بل التي تبني أفضل بنية معرفة، أفضل حوكمة، وأوضح workflows بين التسويق والمبيعات والتحليلات.
عندما يتم بناء Custom AI Knowledge Base بشكل احترافي، يتحول الـCustom GPT من كاتب عام إلى مسوق ذكي، مساعد استراتيجي، ومصدر داخلي لتسريع النمو.
FAQ Section
1. ما الفرق بين Custom GPT وCustom AI Knowledge Base؟
Custom GPT هو الواجهة أو المساعد الذي يتفاعل معه المستخدم، بينما Custom AI Knowledge Base هي قاعدة المعرفة التي تغذي هذا المساعد بمعلومات الشركة الداخلية. بدون قاعدة معرفة منظمة، يبقى الـCustom GPT أقرب إلى أداة عامة.
2. هل تدريب نماذج ذكاء اصطناعي خاصة يعني تدريب نموذج من الصفر؟
ليس دائماً. في سياق الشركات، المقصود غالباً هو تخصيص النموذج عبر التعليمات، ملفات المعرفة، قواعد العمل، وربما تقنيات Retrieval-Augmented Generation، وليس بناء نموذج لغوي كامل من البداية.
3. ما أفضل البيانات التي يمكن إضافتها إلى Custom GPT للتسويق؟
أفضل البيانات تشمل Brand Guidelines، ملفات المنتجات، Buyer Personas، اعتراضات العملاء، محتوى الموقع، نتائج الحملات، مكالمات المبيعات، ودراسات الحالة. المهم أن تكون البيانات حديثة ومنظمة وخالية من التضارب.
4. هل يمكن استخدام Custom GPT لتحسين SEO وGEO؟
نعم، إذا تم تغذيته ببيانات نية البحث، الكلمات المفتاحية، صفحات الموقع، الأسئلة المتكررة، وتحليلات الأداء. عندها يمكنه إنتاج محتوى أكثر قابلية للترتيب في محركات البحث وأكثر وضوحاً لمحركات الإجابة والـAI Overviews.
5. متى تحتاج الشركة إلى بناء نظام معرفي بالذكاء الاصطناعي؟
عندما تصبح المعرفة الداخلية موزعة بين ملفات وفرق وقنوات متعددة، أو عندما تستخدم الشركة أدوات AI لكن النتائج غير متسقة. النظام المعرفي يصبح ضرورياً عند الحاجة إلى توحيد الرسائل، تسريع الإنتاج، وتحسين جودة القرار التسويقي.
CTA النهائي
إذا كانت شركتك تستخدم أدوات الذكاء الاصطناعي لكن المخرجات لا تزال عامة أو غير متسقة، فالخطوة التالية ليست إضافة أداة جديدة، بل بناء قاعدة معرفة داخلية تجعل AI يفهم عملاءك وسوقك ورسائلك بدقة.
ابدأ مع Mahira عبر حجز AI Content Engine مخصص لشركتك لتحويل معرفة شركتك الداخلية إلى نظام تسويقي ذكي قابل للتوسع.